No hacía falta leer más titulares. Hacía falta separar señal de ruido y responder solo desde evidencia real.
MENDINEWS Agent es una plataforma personal de inteligencia informativa pensada para monitoreo ejecutivo. Ingesta RSS y web, extrae texto legible, clasifica relevancia política y social, genera resúmenes ejecutivos, almacena embeddings en PostgreSQL con pgvector y expone un chat RAG cerrado que solo responde desde noticias indexadas.
Problema real#
Los equipos institucionales y tomadores de decisión no necesitan más volumen de noticias: necesitan detectar señal, priorizar contexto y evitar respuestas inventadas. Leer titulares crudos, navegar portales dispersos y depender de memoria humana genera ruido operativo y baja confiabilidad.
Solución#
Diseñé una pipeline de inteligencia ejecutiva que monitorea fuentes, extrae contenido, puntúa relevancia, genera digests estructurados y habilita consulta conversacional únicamente sobre evidencia indexada. El diseño optimiza para confiabilidad institucional antes que para fluidez conversacional.
Qué es la app#
MENDINEWS Agent funciona como una plataforma de monitoreo, enriquecimiento y retrieval sobre noticias. No es un chatbot genérico; es un sistema evidence-first que recolecta artículos, normaliza contenido, produce resúmenes ejecutivos y después habilita búsqueda semántica y preguntas con grounding explícito.
Capacidades principales#
Scraping RSS y web con fallback de extracción.
Clasificación por categoría, importancia, sentimiento y tags.
Resúmenes ejecutivos para briefings de alto valor.
Embeddings y búsqueda semántica en PostgreSQL con pgvector.
Chat RAG cerrado sobre noticias indexadas solamente.
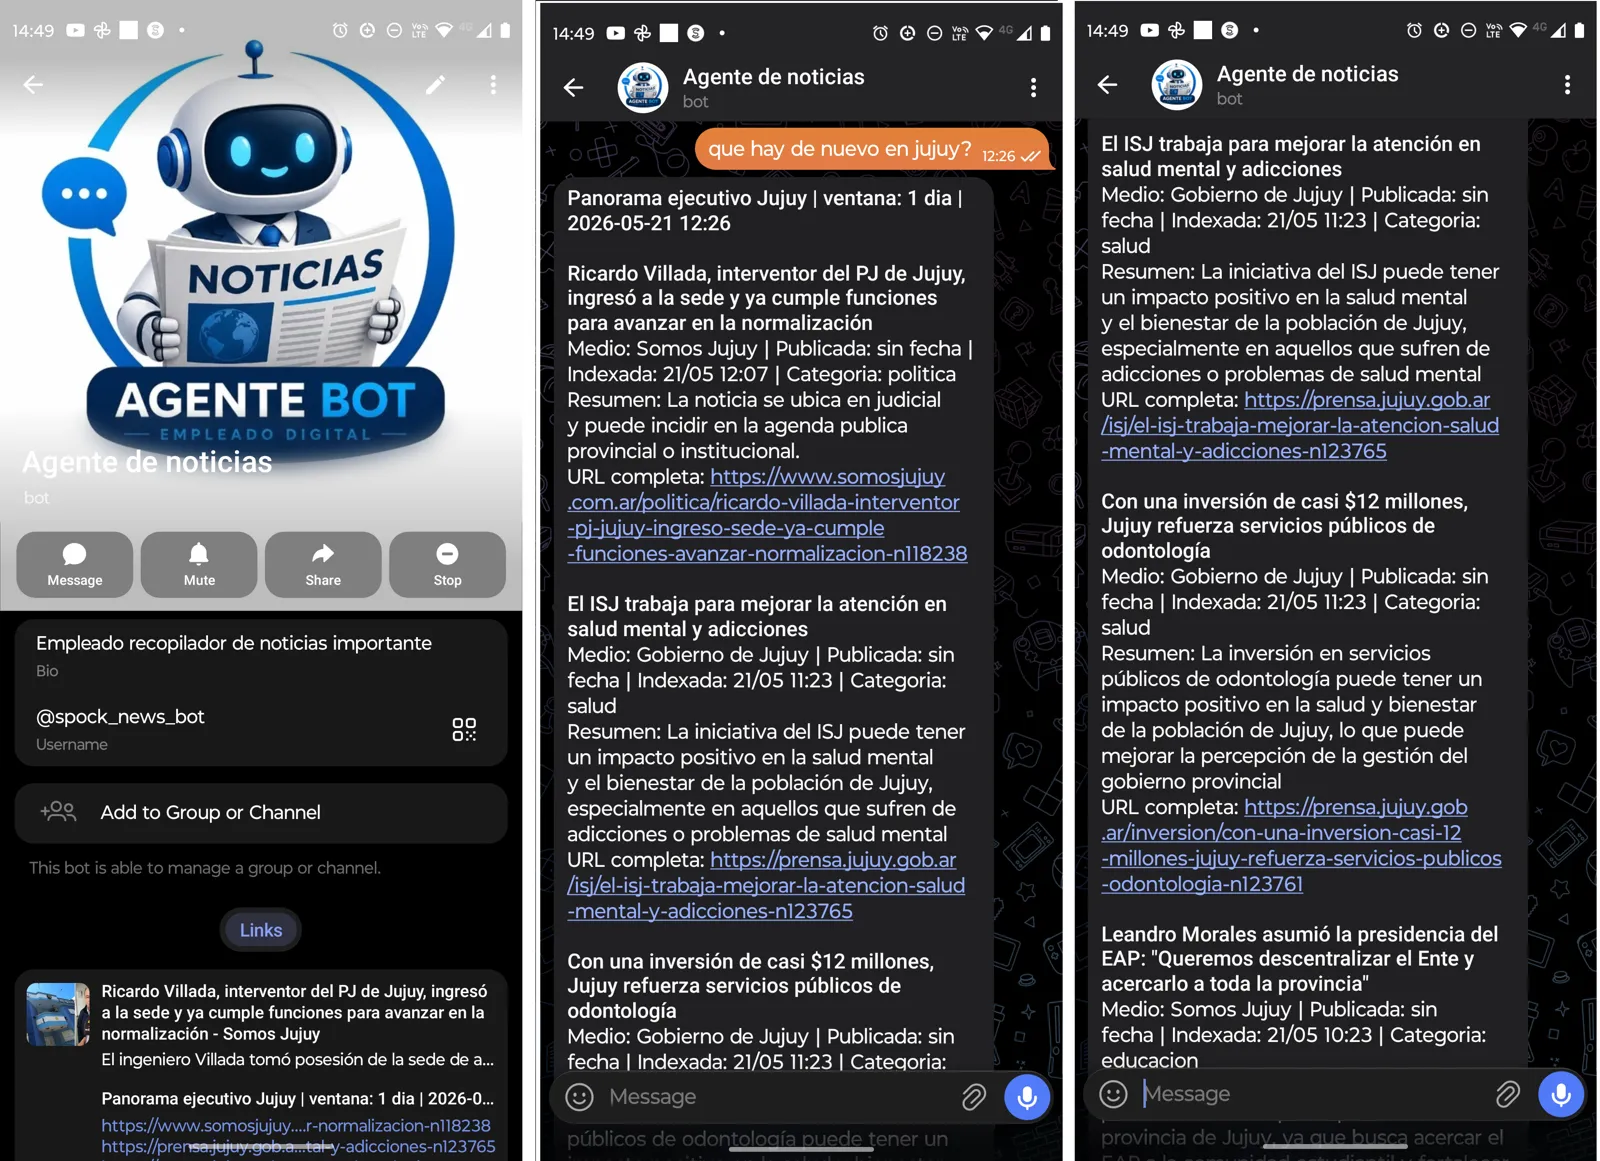
Entrega por Telegram y arquitectura preparada para WhatsApp.
Jobs programados para scraping, digest, health check y preflight.
Base técnica (stack)#
| Tecnología | Rol en el sistema |
|---|---|
| Python 3.12 | Runtime principal de API, jobs y orquestación |
| FastAPI | API HTTP y exposición OpenAPI |
| PostgreSQL | Persistencia relacional de artículos y metadata |
| pgvector | Embeddings y similarity search |
| Groq API | Clasificación, summaries y grounded answers |
| APScheduler | Scheduling in-process para scraping y digest |
| Telegram Bot API | Entrega ejecutiva y comandos operativos |
| Docker + Compose | Runtime portable para local, VPS o cloud |
| GitHub Actions | Automatización de scraping, digest y deploy preflight |
Estructura del proyecto#
`app/scrapers/`: discovery RSS, source registry y extracción con fallback chain.
`app/ai/`: clasificación, summarization, embeddings y RAG cerrado.
`app/db/`: modelos SQLAlchemy, inicialización pgvector y queries.
`app/messaging/`: Telegram activo y contrato preparado para WhatsApp.
`app/jobs/`: scraping programado, digest matutino y health workflows.
`app/main.py` y `app/cli.py`: entrypoints HTTP y operativos no interactivos.
Arquitectura del sistema#
La app está diseñada como pipeline. RSS y scraping web alimentan una capa de extracción; luego clasificación, summary y embeddings enriquecen cada artículo; PostgreSQL + pgvector sostienen retrieval y similarity search; finalmente el chat responde solo si la evidencia recuperada supera umbrales y pasa una validación post-generación.
Scraping → extracción → clasificación → embeddings → storage → retrieval → grounded generation.
Vector retrieval filtrado por similitud, recencia, allowlist de fuentes y reranking contextual.
API, Telegram, jobs y GitHub Actions comparten los mismos entrypoints operativos.
Estrategia anti-hallucination#
No existe ruta directa user → LLM: toda respuesta pasa por retrieval primero.
Threshold mínimo de similitud antes de permitir grounding.
El modelo recibe evidencia estructurada en JSON, no contexto libre.
Las respuestas válidas deben incluir citas coherentes con la evidencia recuperada.
Temperatura 0.0 y abstention explícita cuando el contexto es débil o contradictorio.
Respuesta de abstención: “No encontré información suficiente en las noticias indexadas.”
Superficie funcional#
`GET /health`: salud del servicio y volumen indexado.
`GET /news/latest`: últimos artículos persistidos.
`GET /news/search`: búsqueda keyword sobre títulos, summaries y contenido.
`POST /chat`: consulta RAG cerrada con citations y grounded flag.
`GET /digest/today`: payload del digest del día.
`POST /integrations/telegram/webhook` y `GET /integrations/whatsapp/webhook`: contratos de canal.
Operación y despliegue#
La plataforma está preparada para correr en local, Docker, VPS y proveedores gestionados como Railway, Render o Fly.io. El diseño desacopla la API web de la automatización periódica: la web expone retrieval y salud, mientras GitHub Actions puede ejecutar scraping, digest y deploy preflight sin competir por recursos de chat.
Resumen del proyecto#
Desarrollé MENDINEWS Agent como un sistema de inteligencia informativa evidence-first para monitoreo ejecutivo. Diseñé la API FastAPI, la pipeline de scraping y extracción, la capa de clasificación y summaries, el almacenamiento semántico con PostgreSQL + pgvector, la integración de Telegram y una arquitectura RAG cerrada con abstención, citas y validación post-generación.
Si buscan construir productos de información confiables con RAG y automatización operativa, este es el tipo de sistema que me interesa seguir desarrollando.
Trabajo donde arquitectura, criterio técnico y confiabilidad del output importan más que el demo superficial.